MLB AI予想モデル|
特徴量と特殊要因で導く勝敗ロジック
本記事では、モデル構造とバックテストに加え、球場要因・打線の組み合わせ・リアルタイム事象と世論という3つの特殊要因を取り上げ、Mysports.AIがMLBを分析する方法を説明します。
 レイズ TBR
 ガーディアンズ CLE
MLBの確率予想には、大量のチームと選手のデータを統合する必要があります。打率、出塁率(On-base Percentage, OBP)、長打率(Slugging Percentage, SLG)、加重出塁率(Weighted On-base Average, wOBA)、投手の防御率(Earned Run Average, ERA)、1イニングあたりの被出塁率(Walks plus Hits per Inning Pitched, WHIP)、9イニングあたりの奪三振(Strikeouts per Nine Innings, K/9)などの指標に加え、チーム成績、日程、先発ローテーション、リアルタイムスコアを取り入れます。機械学習モデルはこれらから特徴と潜在的なパターンを識別して確率を推定し、的中率と安定性を継続的に検証します。
モデルはMLBの当日の試合と過去データも動的に分析し、選手のコンディションとチームの直近のパフォーマンスを評価します。リアルタイムデータの更新とモデルの調整に応じて、分析結果はMLBの試合の判断と野球ベッティングの意思決定における定量的な参考情報になります。
MLB AI予想モデルの性能
過去3シーズン(2023~2025)の試合を対象としたバックテスト(Backtesting)では、「モデル厳選試合」の平均的中率は約 68% です(モデルは信頼度の高い試合のみを選択しており、シーズン全試合を予想するものではありません)。最新バージョン(v24)では約 70% です。過去3シーズンの平均投資収益率(Return on Investment, ROI)は約 14%、最新バージョン(v24)では約 16% です。
予想モデルのバージョン
モデルは検証結果に基づいて継続的に更新され、各バージョンの的中率、投資収益率、調整内容を公開しています。モデルの変遷と成績の差を確認いただけます。ここでのバージョンは、MLB単体の予想モデルの学習バージョンです。各リーグのモデルは学習完了後に統合され、サブスクリプションプランの演算モデル(エキスパートプランはv4.8)になります。
- ABS(自動ストライクゾーン)の特徴量を追加:2026年の新制度がストライクゾーンの一貫性、四球、三振に与える影響を反映
- 球場要因(Park Factor)を追加:各球場の得点環境(Coorsの高地を含む)を入力に反映
- 先発投手をシーズン平均に代えて直近3/10/50試合の加重に変更し、調子をより早く反映
- ブルペン疲労指数を追加(直近数日の投球数と連投)
- 打者の直近の調子を、単純な打率に代えて wOBA、Hard-Hit% の加重で評価
- 左右の投打対戦(platoon)の分割を追加:先発投手の対左打者/対右打者のデータを個別にモデル化
- 既存の要因は前シーズンのレギュラーシーズン全試合(約2,430試合)でウォークフォワード検証(Walk-forward Validation)を行い、バージョン23と同一サンプルで比較。ABSは2026年の新制度で過去のサンプルがないため、ルールベースの事前分布として導入し、リリース後に重みを逐次キャリブレーションしています。バックテストの比較には含めていません。
- 先発投手の登板部分とブルペンの継投部分の予想誤差を分けて確認し、得点推定のズレの原因を特定
- 先発投手は野球で最大の試合単位の変数です:先発が確定してから計算する方式に変更し、誤った先発での推定を防ぐことで、予想全体の安定性を高めました
- シーズン開幕後2週間は自動的に信頼度を引き下げ、サンプル不足を反映
- 単一レーティングから投打2系統の評価に変更(先発投手 + 打線)
- 予想得点モジュールを追加:先発のERA/xFIP × チームの得点力で両チームの予想得点を算出
- WHIP、K/9 などの投手の基礎要因を追加
- 球場要因は未導入(バージョン24で追加済み)
- 単一シーズンのレギュラーシーズンでバックテストを行い、シーズン序盤と中盤のサンプルを区別していません
- 勝敗の的中率は向上したものの、ホームアドバンテージがやや過大評価されていました(バージョン24で修正)
モデルの基礎要因
モデル要因の網羅性と質は、予想の的中率に直接影響します。打撃、出塁、投球などの基本指標に加え、モデルはMysports.AI全体の1,500以上の特徴量から野球に関連するものを取り出し、試合結果への影響が大きい中核データを選別したうえで、関連性の低いノイズを除外して干渉を抑えています。
特徴量の選別が不十分だと、過学習(Overfitting)や系統的なバイアスが生じ、実際の場面でのモデルの汎化性能を損なうおそれがあります。特徴量を適切に選ぶことが、予想の的中率と安定性を保つ鍵です。
下の図はモデルの特徴量重要度の上位を示しており、数値は各特徴量が予想結果に与える相対的な寄与度を表します。MLBモデルは多数の特徴量を使用しますが、重要度は少数の主要指標に集中します:上位の特徴量はおおむね 2~10%、残りのロングテールの特徴量はそれぞれさらに小さく、正常で健全な分布です。
モデル構造:データから予想までの4層パイプライン
モデル構造は毎日稼働する4層のデータパイプラインで、データ統合、特徴量エンジニアリング、モデル学習、試合前の推論を順に行います。手法の詳細はスポーツベッティングAIアルゴリズム解説をご覧ください。
- ① データ層:MLB公式 Stats API から各試合のbox scoreを取得し、投手と野手の試合ごとのデータに分解します。試合中はbox scoreがリアルタイムで更新され、試合後に最終データを取得します。アドバンスド指標(wOBA、xFIP、Hard-Hit%)は公開されているアドバンスドデータから取得し、さらに複数の有料サードパーティデータソースを統合(Sportradar、Genius Sports、Stats Performなど)して相互検証と補完を行っています(実際に採用しているソースは商業契約に関わるため、個別の公開は控えています)。状況変数には先発投手、休養日数、ホーム・アウェーなどが含まれます。2026年からMLBが導入した ABS(自動ストライクゾーン)チャレンジシステムも、新たな状況特徴量として取り入れています。
- ② 特徴量エンジニアリング層:生データを予想に役立つ特徴量に変換します。アドバンスド効率指標(wOBA、xFIP、WHIP)、直近の調子の加重(直近3/10/50試合)、先発とブルペンの疲労指数などが含まれます。特徴量の質はモデル性能の上限を大きく左右します。
- ③ モデル層:野球は構造化された表形式データであり、主力は勾配ブースティング決定木(Gradient Boosted Decision Trees, GBDT)系(LightGBM、XGBoost、CatBoost)です。深層学習では TabNet(表形式データ向けのアテンションネットワーク)と LSTM/Temporal 系列モデルで先発投手と打線の直近の調子の傾向を捉え、必要に応じてグラフニューラルネットワーク(Graph Neural Network, GNN)で選手/チーム間の相互作用をモデル化します。最後に確率キャリブレーション(Probability Calibration、Isotonic/Platt)を行い、アンサンブル学習(Ensemble Learning)で単一モデルの偏りを抑えます。
- ④ 推論・更新層:毎日試合前に再計算し、最新の先発投手、負傷者リスト、オッズの変動、天候情報を反映します。出力は「ホームチーム勝率 61.3%」のような確率の推定であり、確定的な判断ではありません。
この種の手法は野球界で長い実務の蓄積があります。MLB公式 Stats API はリアルタイムのbox scoreと試合ごとのデータを提供しており、モデルの毎日の更新を支えるデータ基盤です。AIによる定量分析は、MLBではすでに正式な技術として活用されています。各リーグ(MLB/NBA/NHL)は同じデータパイプラインとモデル構造を共有していますが、学習とキャリブレーションはリーグごとに個別に行っています。競技ごとに試合の展開、サンプル数、取得可能な特徴量が異なり、重みを共有するとかえって的中率が下がるためです。
評価指標:モデルの信頼性の検証
モデルの信頼性は的中率だけでは判断できません。少なくとも的中率、ハンデのカバー率、確率キャリブレーション、投資収益率の4指標を同時に確認する必要があります。
| 指標 | 意味 | 目安 |
|---|---|---|
| 勝敗の精度 Accuracy | 勝者を正しく当てた割合 | MLBはランダム性が高く、成熟したモデルで約55~60% |
| ハンデ/オーバー・アンダーのカバー率 ATS | run line/totalのオッズ基準を上回った割合。精度より高い水準が求められます | 約52.4%が損益分岐点 |
| 確率キャリブレーション Brier Score | 勝率60%とした試合が、長期的に本当に6割勝っているか | 低いほど良い(完全=0) |
| 投資収益 ROI | モデルどおりに運用した場合の、100単位あたりの投資収益 | 正の値はリターンがコストを上回ることを示します |
バックテストと実運用は分けて評価する必要があります:バックテストは過去データを使い、当時の条件下でのモデルの結果をシミュレーションするものです。設計が不適切だと、過学習やデータリーク(Data Leakage)によって成績を過大評価するおそれがあります。より厳密な方法がウォークフォワード検証で、その時点までのデータのみで学習し、次の期間を予想したうえで各バージョンの成績を公開します。私たちがすべての予想を実績ページに保存しているのもこのためで、実運用の記録として検証の根拠を提供しています。
モデルが読み取る指標:アドバンスド指標ミニ辞典
アドバンスド指標は、選手のパフォーマンスを比較可能なモデルの特徴量に変換します。下の表に各指標の定義と測定のポイントをまとめました。
| 指標 | 何を測るか |
|---|---|
| wOBA(加重出塁率) | 出塁の種類ごとの実際の得点価値で加重した指標で、打率よりも打者の実際の貢献に近い値になります |
| WAR(勝利貢献度) | 代替可能な控え選手と比べて上積みした勝利数で、総合的な価値を測ります |
| xFIP(期待守備独立防御率) | 被本塁打率を平準化したうえで、投手がコントロールできる結果だけを見る防御率 |
| WHIP(1イニングあたりの被出塁率) | (被安打+与四球)÷投球回で、投手が1イニングあたり何人の走者を出すかを測ります |
| K/9(9イニングあたりの奪三振) | 投手の9イニングあたりの平均奪三振数で、支配力を測ります |
| Hard-Hit%(ハードヒット率) | 打球初速が 95 mph 以上の打球の割合で、打者の打球の質を測ります |
| ABS(自動ストライクゾーンシステム) | 2026年にMLBが導入したストライクゾーンのチャレンジシステムで、Hawk-Eyeがリアルタイムでストライク/ボールを判定します。モデルはこれを使い、ストライクゾーンの一貫性が四球、三振、重要なカウントに与える影響を測ります |
MLBスポーツベッティング分析におけるAIの4つの実践シーン
- オッズの価格のズレの検出:モデルの勝率とオッズのインプライド確率を比較し、その差が期待値(Expected Value, EV)になります。AIの主な役割は、市場の価格設定とデータに基づく評価のズレを見つけることです。
- オーバー/アンダー(Total Runs)モデル:両チームの先発投手のxFIP/K9、ブルペンの疲労、打線のwOBAに、球場要因と天候・風向きを掛け合わせます。モデルはこれらの相互作用を定量化し、構造的なオーバー/アンダーの傾向を人の判断より早く捉えます。
- 先発投手の影響モデル:先発ローテーション、休養日数、ブルペンの使用状況は1試合の勝率を大きく左右します。AIは投手の直近の調子と相手打線との相性を計算し、単に「知名度で判断する」方法に代わる評価を行います。
- 打者の調子の傾向:打者の直近3/10/50試合のwOBA、Hard-Hit%が基準ラインから継続的に乖離している場合、オッズがその調子の変化を十分に反映していない可能性があります。AIはこうした市場の調整の遅れを定量化できます。
この4つのシーンはいずれも公開データを使った体系的な計算で、分析のスピードと精緻さを高めることに重点を置いています。下記の3つの特殊要因と組み合わせたものが、Mysports.AIモデルの日々の分析フローです。モデルの出力をオッズと照らし合わせ、ハンデとオーバー/アンダーを読み解く方法は、MLB AI予想:ハンデ、オーバー/アンダーと当日の試合の読み方をご覧ください。
モデルの特殊要因①:球場要因
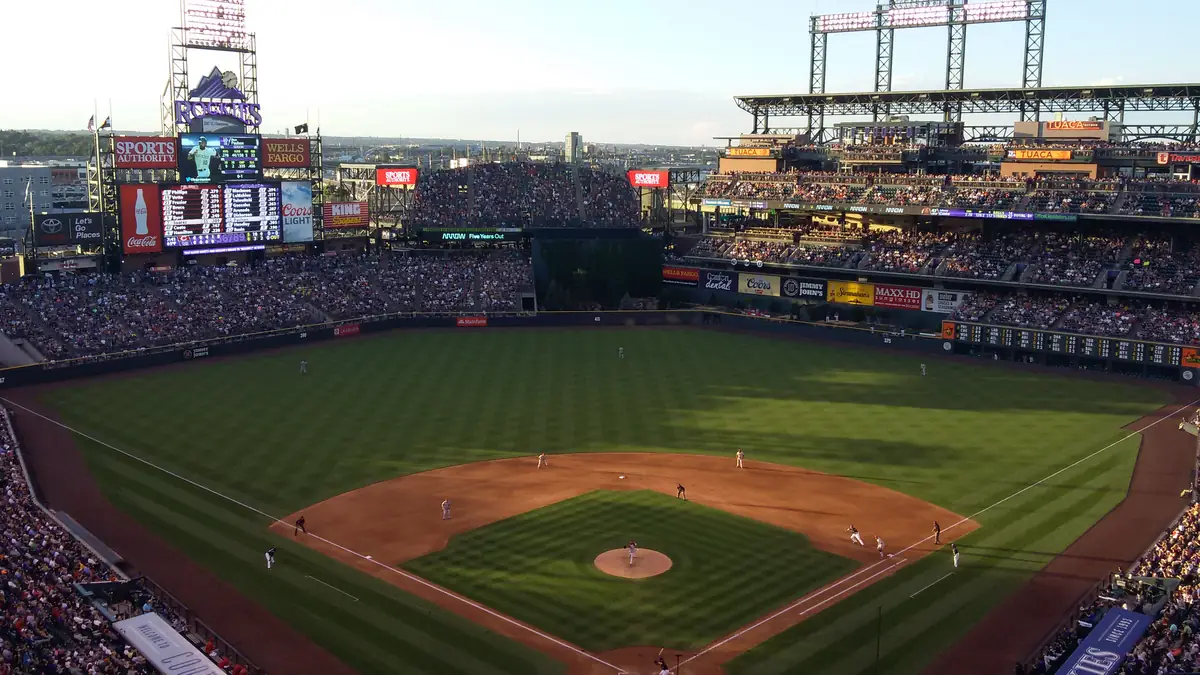
球場要因(Park Factor)は、球場ごとの得点環境の差を直接補正します。球場の広さ、ファウルゾーンの大きさ、標高、気候は大きく異なり、データテーブルの park_factor 列(例:1.04)がその定量係数です。1より大きければ打者有利、1より小さければ投手有利を意味します。
- 標高と空気密度:コロラド・ロッキーズの本拠地 Coors Field は標高約1,580メートルにあり、空気が薄いため打球がよく飛びます。長年にわたりリーグで最も打者有利な球場です。
- 球場の広さとファウルゾーン:フェンスまでの距離、外野の広さ、ファウルゾーンの大きさは、いずれも安打とアウトの確率を変えます。
- 気候と風向き:気温、湿度、風向きは打球の飛距離に影響し、モデルは球場要因とあわせて取り入れています。
Coors Field は MLB Statcast Park Factors で長年最も高い球場の1つです(指数は約112、100がリーグ平均)。出典:Baseball Savant · Statcast Venue Park Factors。
モデルの特殊要因②:打線と守備の組み合わせ
打線、左右の打者の組み合わせ、バッテリーの組み合わせは、得失点の効率をともに変えます。同じ9人の打者でも打順が違えば結果は変わり、投手と捕手(Battery)の配球の連携も失点に影響します。私たちは直近の打線の組み合わせの得点データで定量化しています。
| 打線の組み合わせ(直近の先発オーダー) | 試合数 | 1試合あたり得点 | 1試合あたり失点 | 得失点差 |
|---|---|---|---|---|
| 先発オーダー A | 22 | 5.4 | 3.9 | +1.5 |
| 先発オーダー B | 18 | 4.1 | 4.8 | -0.7 |
私たちの対応:ロスターや打順の変動により不確定要素が多すぎる場合、モデルはそのチームを予想対象から除外します。新しい組み合わせで変動のない試合データが約10試合分以上たまってから、この要因の出力を再開します。
モデルの特殊要因③:リアルタイム事象と世論の異常検知
MLBで勝敗に最も影響するのは先発投手ですが、先発投手もスタメンも試合当日まで確定しないことがよくあります。各チームは予告先発を事前に発表しますが、直前の変更(scratch)も珍しくありません。スタメンは通常、試合開始の数時間前に発表され、天候によって試合が遅延・延期されることもあります。モデルはAPIで先発投手の変更、スタメン発表、負傷者リスト(Injured List)、天候による延期を追跡し、感情分析と話題量の異常検知でリアルタイムの状況シグナルを補完します。
- イベント・投稿の収集:チームや選手のキーワード、試合タグをもとに、APIでイベントと関連するSNS投稿を収集します。
- クリーニングと処理:リンク、ノイズ、重複を取り除き、トークン化(Tokenization)と見出し語化(Lemmatization)を行います。
- 感情・異常の検知:ポジティブ・ネガティブ・ニュートラルを判定し、話題量や感情の異常な急増を検知します。
- シグナル抽出:イベントの種類や世論の異常を状況特徴量に変換し、モデルがその試合の信頼度を調整するために使います。
慎重な運用:予告先発の直前変更、主力打者のスタメン落ち、天候による試合遅延が起きた場合、元の対戦評価は成り立たなくなります。モデルは新しい先発投手とスタメンで再計算し、必要に応じて信頼度を下げるか予想を見送ります。スタメンが確定する前に、古い情報のまま高信頼度の予想を出すことはありません。
事例:大谷翔平の移籍。2023年末、大谷翔平は記録的な契約でエンゼルスからドジャースへ移籍しました。エース選手の移籍は両チームの打線構成と話題性を同時に変え、過去のチームデータの代表性が下がります。モデルは事象と世論のシグナルで信頼度を調整し、新しいサンプルがたまってから通常の評価に戻します。
MLB AIモデルのよくある質問
MLBのAI予想の的中率はどのくらいですか?
野球は1試合ごとのランダム性がバスケットボールより高く、成熟したモデルのレギュラーシーズン勝敗の的中率はおおむね55~60%です。それでもランダムに当てる場合の50%を上回ります。利益を保証するサービスは信頼できません。私たちは各バージョンのモデルのバックテスト成績と毎日の実運用の予想を公開し、ユーザーが独自に検証できるようにしています。
AI予想ではどのようなデータを使っていますか?
データは4層に分かれます:従来のbox score、アドバンスド効率指標(wOBA、xFIP、WHIPなど)、選手の試合ごとのデータ(MLB公式 Stats API で試合ごとに更新)、そして先発ローテーション、休養日数、ホーム・アウェーなどの状況変数です。さらに球場要因、打線の組み合わせ、リアルタイム事象と世論の3つの特殊要因を取り入れています。
AIと人間のスポーツベッティングアナリストの違いは何ですか?
人間のアナリストはモチベーションやクラブハウスの雰囲気など、構造化されていない文脈を理解しやすい一方、認知バイアスや処理量の制約を受けることがあります。AIは大量の試合変数を一貫して処理できますが、データ以外の文脈の判断には限界があります。より堅実なのは、AIが選別と定量化を行い、人が最終確認する流れです。
一部の試合にAI予想がないのはなぜですか?
次の2つの場合は出力を停止します:先発投手やロスターに大きな変動があった直後(新しいデータでの再評価が必要なため)と、試合の話題量が異常に多い場合(制御できない要因が増えるため)です。データが不十分なときに、信頼度の低い予想は出しません。
データソースと執筆チーム
- 公式の試合ごとのbox scoreとリアルタイムデータ:MLB公式 Stats API
- wOBA、xFIP、WARなどのアドバンスド指標の定義:FanGraphs
- チーム成績、cLI(チャンピオンシップ・レバレッジ指数)、球場要因:Baseball-Reference
- 公式データと日程:MLB.com Stats
- ABS(自動ストライクゾーン)2026年新制度の解説:Baseball-Reference · ABS Challenge Analysis
- 本ページの数値の定義:的中率はモデル厳選試合の過去のバックテスト値です(過去3シーズン平均 約68%、最新版 約70%)。ROIも過去のバックテスト値です(過去3シーズン平均 約14%、最新版 約16%)。
モデルは野球関連の特徴量と特殊要因を組み合わせ、毎日決まった時刻に再計算しています。すべての予想は実績ページに保存されており、ユーザーが検証できます。